llms.txtの目的とrobots.txt・XMLサイトマップとの違い、主要製品で確認できる対応範囲を整理。効果を保証しない前提で、導入・限定試行・見送りを判断する3つの基準を解説します。
この記事の目次
llms.txtに関心が集まる一方で、「主要なAIサービスが読んでいるのか」「検索順位やAI回答での引用に影響するのか」は別々に確認する必要があります。llms.txtは、選択した公開情報をMarkdown形式で整理し、詳細ページへ案内するオープンな提案です。すべてのサイトに必須の規格ではなく、設置による成果を保証する仕組みでもありません。
判断では、提案の目的、対象製品による明示的な処理、順位・引用・流入・問い合わせなどの事業成果を切り分けます。この記事では公式資料で確認できる範囲と運用条件を整理し、自社が「導入・限定試行・見送り」のどれを選ぶべきか判断できる状態を目指します。
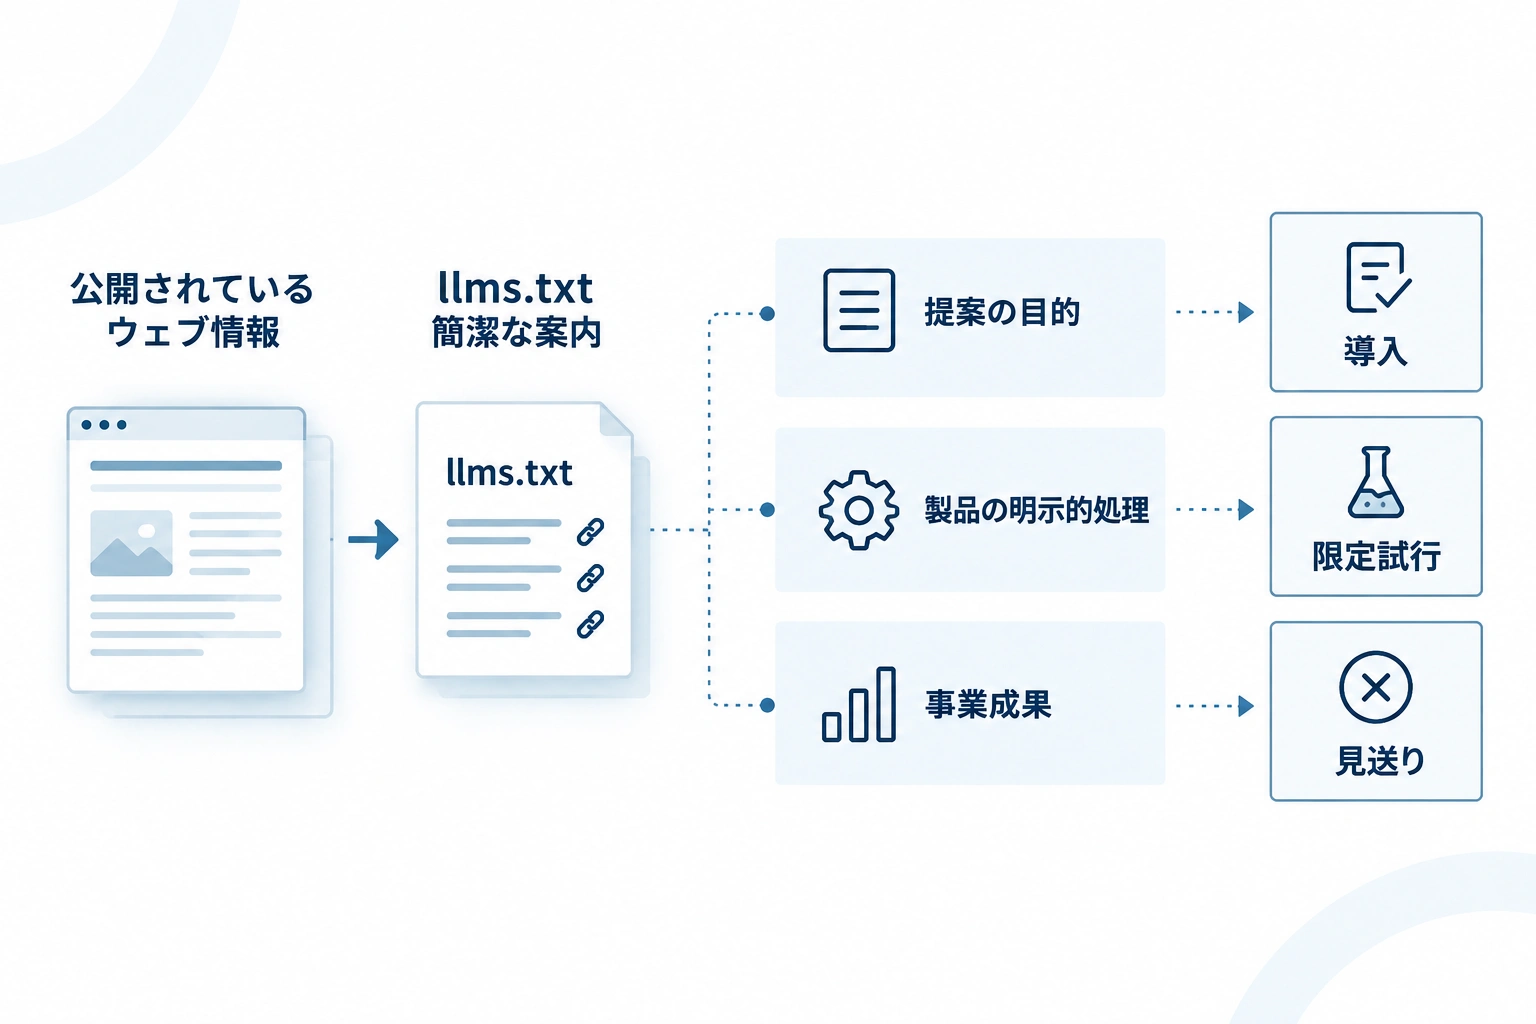
llms.txtの提案そのもの、製品側の対応、事業成果は別の論点です。導入判断では3つを分けて確認します。
llms.txtの位置づけ
llms.txtの提案では、Webサイトにある重要な公開情報を選び、短い説明と詳細ページへのリンクをMarkdownファイルにまとめる方法が示されています。サイト内の製品情報、ドキュメント、方針、サポート情報などが分散している場合に、参照先を案内するための目次に近い役割です。
提案上の代表的な配置例は https://example.com/llms.txt です。サイト直下だけでなく、特定のサブパスに置く方法も説明されています。ただし、これはオープンな提案として示された配置方法であり、すべてのWebサイトやAIサービスに共通する必須要件ではありません。
形式はMarkdownで、提案上はH1が唯一の必須要素です。短い概要、説明文、H2ごとのリンク集などは推奨される構成要素ですが、各AIサービスが共通して要求しているわけではありません。ファイルを作成しただけで、サービスが取得・参照・引用することまで決まるものでもありません。
導入判断では、次の3層を混同しないことが重要です。第1層は、llms.txtが何を目的に提案されているか。第2層は、特定の製品がllms.txtをどのように処理すると明示しているか。第3層は、順位、引用、流入、問い合わせなどの成果が確認されているかです。第1層が確認できても、第2層や第3層まで自動的に成立するわけではありません。
また、llms.txtはアクセス制御の仕組みではありません。非公開情報を守る用途には使えず、検索エンジンへの登録を指示するファイルでもありません。公開して問題のない情報だけを選び、元の公開ページへ案内することが基本です。
既存ファイルとの違い
llms.txtを検討するときは、robots.txt、XMLサイトマップ、通常の公開ページとの役割の違いを押さえる必要があります。いずれかを置き換えるものではなく、別の情報案内を追加する提案です。
資産 | 主な役割 | 保守の境界 |
|---|---|---|
llms.txt | 選択した公開情報と詳細ページを案内する、提案形式のガイド | 内容を簡潔に保ち、変わりやすい事実は元ページへのリンクで示す |
robots.txt | クローラーによるアクセス範囲を案内 | 情報案内とは分けて、クローラーごとのアクセス方針を管理する |
XMLサイトマップ | サイト内のURLや更新情報を検索エンジンへ伝え、発見やクロールを助ける | 対象URLや更新状況をサイト構成に合わせて保つ |
公開ページ | 読者とアクセス可能なシステムが参照する事実の基準 | 製品、価格、方針、提供状況などの記述を正確かつ最新に保つ |
Google Searchのrobots.txt解説では、robots.txtはクローラーのアクセスを管理するためのものと説明されています。ページを確実に秘匿する仕組みではなく、公開情報を要約して案内するllms.txtとも役割が異なります。
XMLサイトマップの解説では、サイト内のページやファイルに関する情報を検索エンジンへ伝える役割が示されています。ただし、サイトマップにURLを含めても、クロールやインデックス登録が保証されるわけではありません。llms.txtも同様に、ファイルの存在だけから各サービスによる処理や成果を推定できません。
最も重要なのは公開ページです。価格、製品仕様、利用条件、方針など、変更される可能性がある情報をllms.txtへ詳しく複製すると、更新漏れによって内容が食い違うおそれがあります。llms.txtには案内に必要な説明だけを置き、事実の詳細は元の公開ページで管理するのが安全です。
対応状況の確認
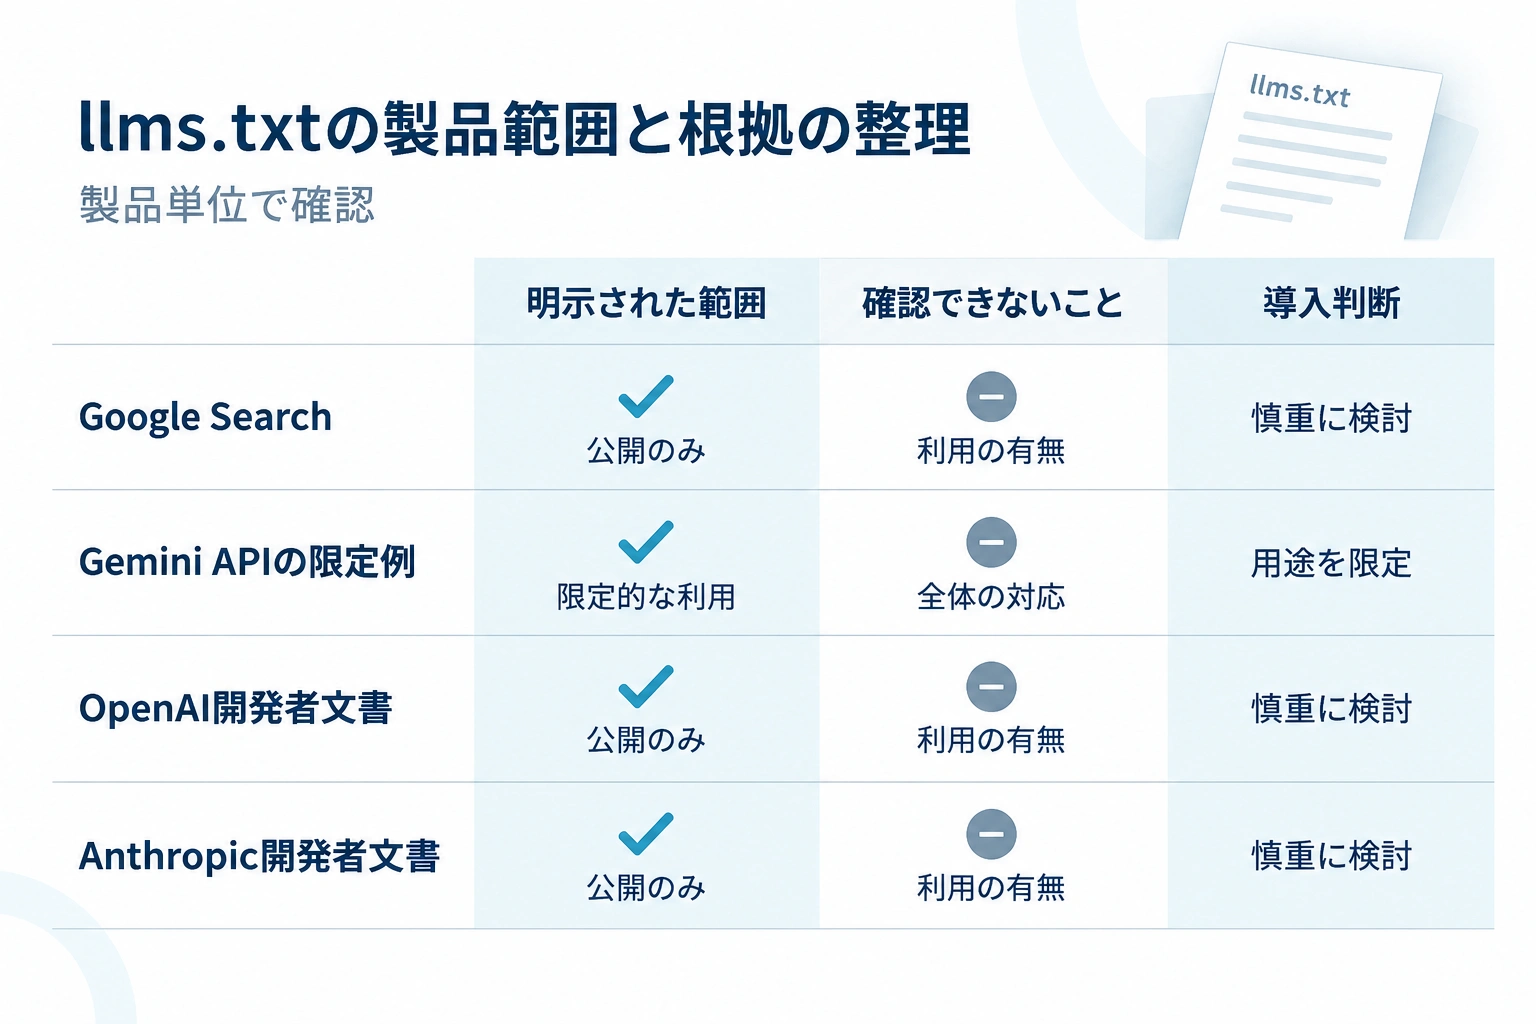
対応状況は企業名で一括りにせず、対象製品、処理目的、適用範囲を公式資料で確認します。
サービスの対応状況は、会社名やブランド名ではなく、製品単位で確認します。検索、一般向けAIサービス、API、開発支援ツールでは、同じ企業が提供していても処理が異なる可能性があるためです。
対応状況には確認日と製品範囲が必要
以下は2026年10月5日に公式資料を確認した範囲です。仕様や方針は変わる可能性があるため、記事の公開直前と、自社が導入を判断する時点の両方でリンク先を再確認してください。
対象製品・範囲 | 公式資料で明示されていること | 区分 | 導入判断での読み方 |
|---|---|---|---|
Google Search | Google SearchのAI機能向け案内では、検索結果や生成AI機能への表示のためにllms.txtを使用せず、検索での表示やランキングを助けも害もしないと説明 | Google Searchでの非利用を明示 | Google Searchの順位や表示改善を目的に導入する根拠にはならない |
Gemini APIの特定のコーディング支援ワークフロー | Gemini APIの資料では、文書取得の代替手段として | 限定された処理を明示 | 一般企業のサイトやGeminiの全製品が処理する証拠にはならない |
OpenAIの開発者向け文書 | 第三者サイトの処理は確認できず | 自社文書の公開は、ChatGPTなどが企業サイトのファイルを処理する証拠ではない | |
Anthropicの開発者向け文書 | 第三者サイトの処理は確認できず | 自社文書の公開だけから、Claudeなどの対応を推定しない |
Google Searchの説明は、Google Searchと同サービス内の生成AI機能に限ったものです。他社サービスはもちろん、Googleが提供する別製品の挙動へ一般化できません。一方、Gemini APIの例は実際の処理が明記されていますが、対象となるワークフローとドメインが限定されています。
OpenAIとAnthropicについて確認できるのは、各社が開発者向け文書のllms.txtを公開していることです。それだけでは、一般向け製品や検索機能が第三者企業のllms.txtを取得し、回答や引用に利用するとは判断できません。
自社で再確認するときは、対象となる正確な製品名、公式資料のURL、llms.txtへの明示的な言及、処理目的、対象範囲や制限、確認日を記録します。クローラー方針、robots.txtの説明、学習データ方針、その企業自身によるllms.txtの公開だけでは、第三者サイトへの対応を裏付ける資料としては不十分です。
当社では、サービス名だけを見て対応を推測せず、根拠となる一次資料を先に確認します。取得、検索、回答生成、引用、ランキングは異なる処理なので、どこまで明示されているかを分けて読むことが重要です。
効果の見極め
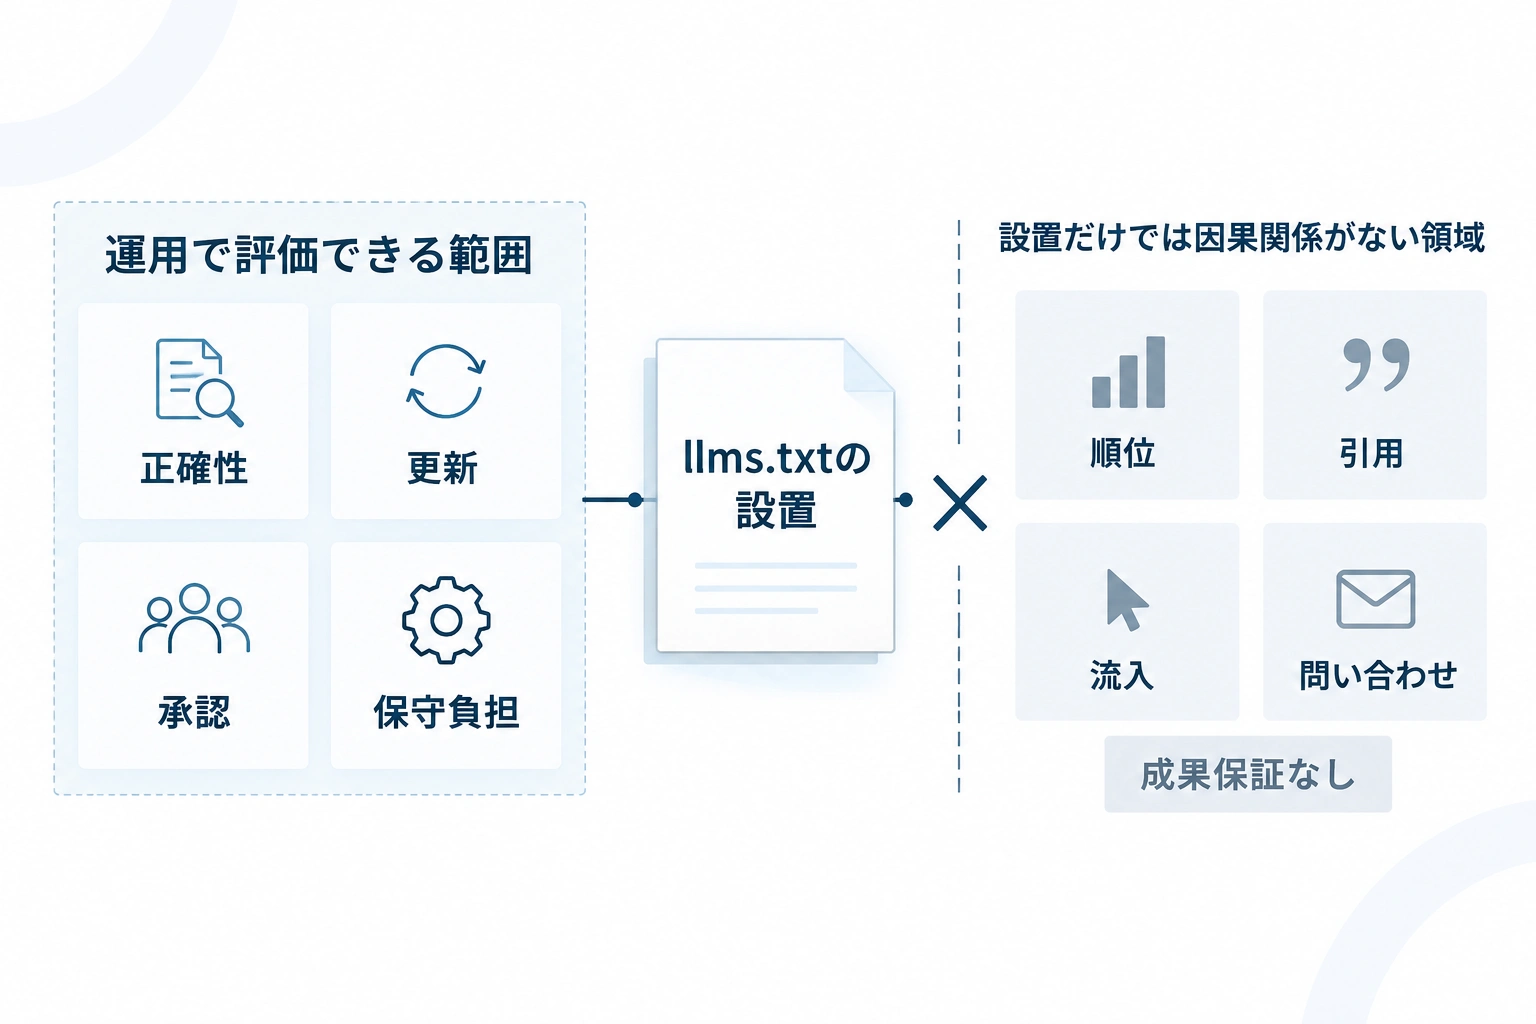
限定試行では事業成果を保証するのではなく、正確性や更新・承認の運用を確認します。
設置と事業成果は分けて評価
llms.txtの設置だけを根拠に、検索順位、AI回答での引用、流入、問い合わせ、コンバージョン、見込み客獲得の改善を見込むことはできません。限定試行も、これらの成果との因果関係を証明するものではありません。
2026年10月5日の確認範囲では、Google Searchはllms.txtが同サービスでの表示やランキングに影響しないと明示しています。この説明から分かるのはGoogle Searchでの扱いであり、他社製品の効果まで否定または肯定するものではありません。一方、確認した資料には、サービスを横断して順位、引用、流入、問い合わせなどを改善するという因果的な根拠はありませんでした。
アクセス数やAI経由とみられる参照、問い合わせ件数に変化があっても、同時期のコンテンツ更新、キャンペーン、季節性、サイト改修、計測方法の変更などが影響します。設置前後の差だけで、llms.txtが原因だと判断することは避けるべきです。数値を見る場合は、因果的な効果ではなく、他の変更と併記する参考情報として扱います。
限定試行で確かめやすいのは事業成果よりも運用です。選んだURLと説明を正確に維持できるか、公開ページの変更を追跡できるか、承認が滞らないか、担当者不在でも見直せるかを確認します。つまり、限定試行は「効果検証」ではなく、正確性、保守負担、承認体制を確かめる運用学習です。
情報が古くなったllms.txtは、参照先を整理するという本来の目的に反します。期待効果が確認できない段階では、導入の優先度を成果予測ではなく、案内する情報の必要性と維持可能性から決める方が合理的です。
導入の3分岐
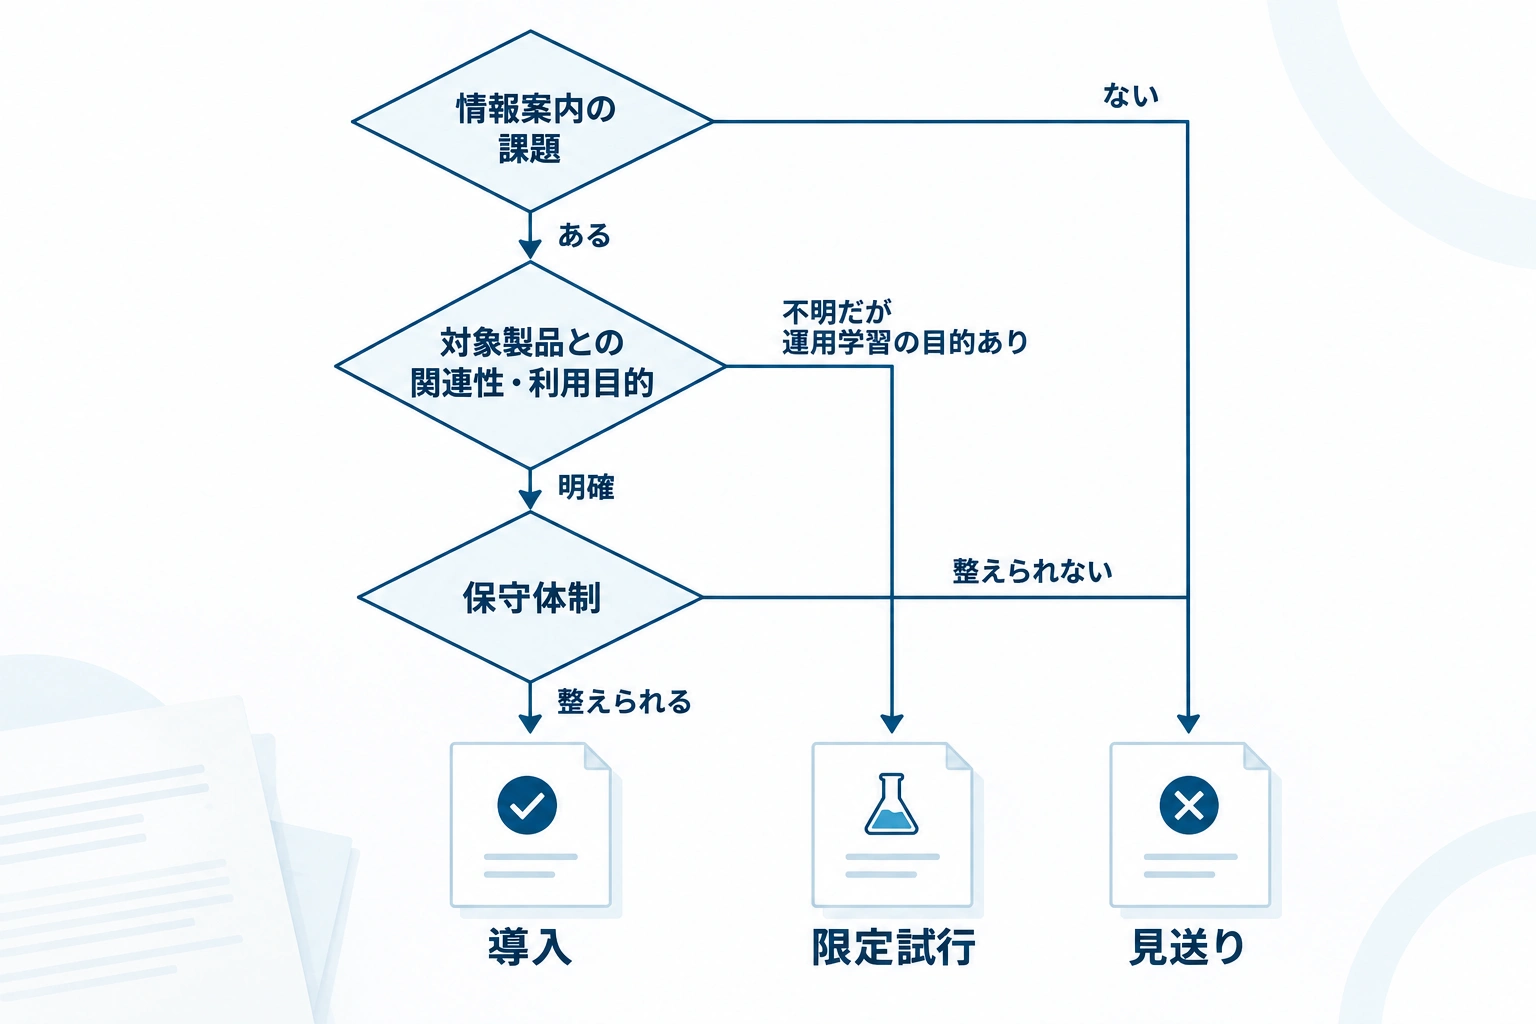
話題性ではなく、情報案内の目的、対象製品との関係、継続して保守できる体制の順で判断します。
導入判断は、話題性ではなく「案内する必要がある情報」「対象製品との関係」「維持できる体制」の順で進めます。次の3問に答えると、結論を導入・限定試行・見送りのいずれかに絞れます。
1. サイト内に、具体的な情報案内の課題があるか
製品、ドキュメント、方針、サポートなどの公開情報が分散しており、重要な参照先を選んで案内する必要があるなら、2問目へ進みます。何を誰に案内したいのか説明できない場合は、まず公開ページやナビゲーションを整えるべきなので、結論は見送りです。
2. 優先する製品で関連性のある明示的な処理が確認できるか、別の明確な利用目的があるか
対象製品の公式資料に、自社の用途と関係する処理が明記されている場合、または社内で文書化された別の利用目的がある場合は、3問目へ進みます。対応が確認できなくても、狭い範囲で運用上の学びを得る目的が明確なら限定試行です。学ぶべき運用課題も定まらない場合は見送りを選びます。
3. 正確な範囲、公開権限、継続的な担当を維持できるか
対象範囲を絞り、事実確認、公開、見直し、削除の責任を割り当てられるなら導入です。一部の役割や更新方法だけが未確定でも、対象を限定して確かめられるなら限定試行とします。正確性や公開後の保守に責任を持てない場合は見送りです。
ここでの導入は、情報案内としての目的と運用体制が整っているという判断です。順位、引用、流入、問い合わせなどの成果が期待できるという意味ではありません。限定試行も、広い範囲へ展開する前に運用上の不確実性を減らす選択肢です。見送りは必須要件を逃す判断ではなく、目的や体制が整うまで公開ページの品質を優先する判断になります。
運用と見直し
導入または限定試行を選んだら、作成者だけでなく、事実確認、公開、見直しの責任を分けます。最低限必要なのは、対象範囲と掲載リンクを決めるコンテンツ責任者、製品・価格・方針・サポート情報を確認する事実確認者、指定場所への公開と外部からの取得確認を担う公開担当者、継続・修正・削除を判断する見直し担当者の4役割です。同じ人が複数を兼ねる場合でも、どの判断を担うかは明確にしておきます。
見直しの契機は、URLやサイト構造の変更、製品・価格・方針・サポート情報の改定、サービス終了やページ削除、公開ページとの不一致の発見です。定例確認だけに頼ると変更から反映までに時間差が生じるため、通常の更新業務からllms.txtの確認につながる運用が必要です。
公開ページとllms.txtの説明が食い違った場合は、公開ページを事実の基準とします。特に価格、提供状況、契約条件、製品仕様、方針などはllms.txtへ細かく複製せず、短い説明とリンクで案内します。これにより、同じ事実を複数箇所で更新する負担と不一致のリスクを抑えられます。
当社では、公開情報に関する最終判断を人が担い、リンク先と記述の根拠を確認してから公開します。ファイル形式が簡潔でも、何を選び、どの表現なら公開できるかは自動的には決まりません。
公開可否の5項目
- 公開ページと説明・URLが一致している
不一致があれば公開ページを基準に修正する
- 対象情報の事実確認と公開承認が完了している
製品、価格、方針、サポートなど該当領域の担当者が確認する
- 公開権限があり、外部から取得できることを確認できる
公開場所と確認担当を記録する
- 変わりやすい事実を複製せず、元の公開ページへリンクしている
llms.txtは簡潔な案内にとどめる
- 見直し日と修正・削除を判断できる担当者が決まっている
放置される可能性がある場合は公開を止める
限定試行では、成果の良し悪しを決める固定の数値基準を設けるのではなく、判断に必要な記録を残します。期間は一律に決めず、自社の更新頻度や承認経路に合わせて、通常の変更を経験できる見直し日を設定します。
限定試行の判断記録
目的と範囲
確かめたい運用上の問い、対象とする情報領域、掲載URL、対象外の領域を記録する。
担当者と公開情報
コンテンツ責任者、事実確認者、公開担当者、見直し担当者、公開日、公開URLを残す。
基準状態と変更履歴
公開前のリンクや更新手順の状態に加え、llms.txtと公開ページの変更、サイト改修、施策、計測変更を記録する。
見直し結果と次の判断
見直し日、リンク切れ、古い説明、承認の遅れ、保守負担を確認し、継続、範囲拡大、修正、削除、見送りの判断を残す。可視性や問い合わせなどの数値は因果的な証明ではなく参考情報として扱う。
llms.txtに関するよくある質問
llms.txtを置けばAI回答に引用されますか?
引用は保証されません。ファイルの提案が存在すること、特定製品が明示的に処理すること、回答で引用されることは別の論点です。対象製品の公式資料に処理目的が書かれているかを確認し、引用や流入を導入効果として断定しないことが重要です。
robots.txtがあればllms.txtは不要ですか?
両者は役割が異なります。robots.txtはクローラーのアクセス範囲を案内し、llms.txtは選択した公開情報への案内を提案するものです。片方がもう片方を代替する関係ではありません。
ページ数が少ない企業サイトでも公開すべきですか?
ページ数だけでは決まりません。重要情報の所在が分かりやすく、公開ページを適切に管理できているなら、案内ファイルを追加する必要性は低い場合があります。具体的な情報案内の課題と維持目的を説明できなければ、見送りが妥当です。
外部の編集支援を利用する場合、URLと説明は誰が承認すべきですか?
原稿作成を外部へ依頼しても、公開可否は情報に責任を持つ企業側が判断します。製品、価格、方針、サポートなどの担当者が元の公開ページと照合し、社内の公開担当者または権限者が最終承認する体制が必要です。